Inhalten in PDF-Dokumenten schnell finden
Lassen Sie Ihre Anwendung bestimmte Texte aus PDF-Dateien finden und extrahieren – ob für Navigation, Validierung oder Datenauswertung.
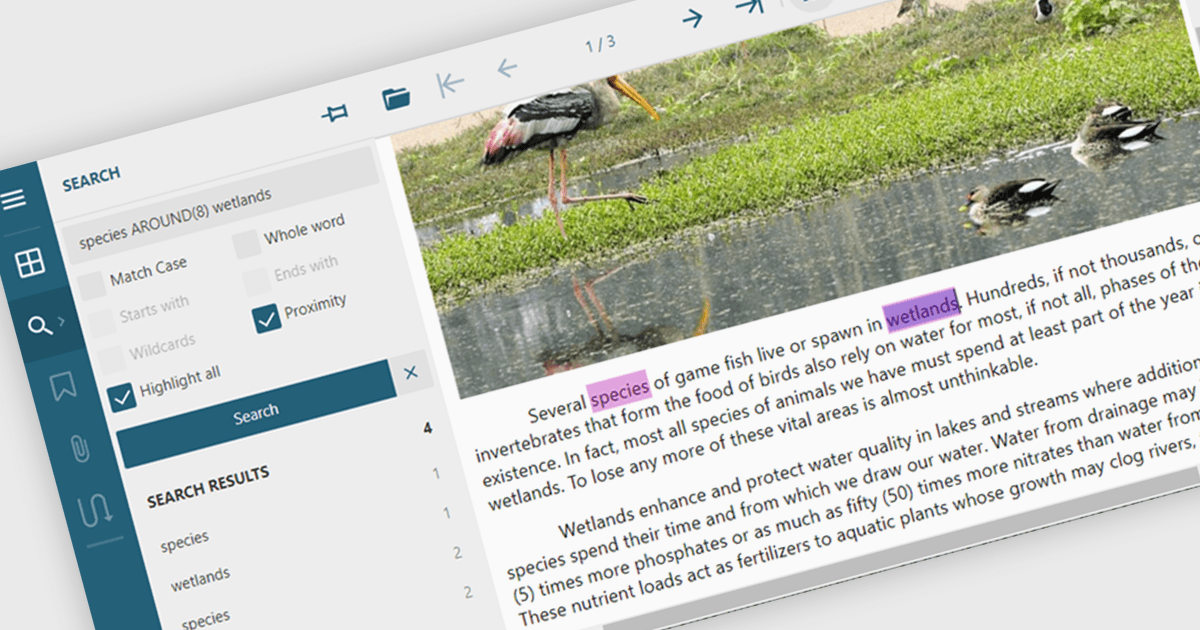
Die Textsuche in einer PDF-Komponente bezieht sich auf die Möglichkeit, programmgesteuert Text innerhalb eines PDF-Dokuments anhand bestimmter Suchkriterien zu finden und zu extrahieren. Diese Funktion unterstützt typischerweise die Groß-/Kleinschreibung, die Übereinstimmung ganzer Wörter und reguläre Ausdrücke, sodass eine präzise Abfrage über Seiten oder Dokumentabschnitte hinweg möglich ist. Für Entwickler erleichtert sie das Erstellen von Funktionen wie Keyword-Highlights, Dokumentenindizierung, Inhaltsvalidierung und automatisierten Workflows zur Anonymisierung. Durch die Integration der Textsuche können Anwendungen effizient mit dem PDF-Inhalt interagieren, ohne dass eine manuelle Prüfung erforderlich ist. Das spart Zeit und verbessert die Datenzugänglichkeit sowie die Genauigkeit in Unternehmens- und Dokumentautomatisierungssystemen.
Mehrere ASP.NET Core PDF-Komponenten ermöglichen es Ihnen, in einer PDF-Datei nach Text zu suchen, darunter:
- Document Solutions for PDF von MESCIUS ermöglicht case-sensitives Suchen nach Text in PDFs für eine präzise Inhaltsverarbeitung.
- Telerik UI PDF for ASP.NET Core (Teil von Telerik UI for ASP.NET Core) ermöglicht das Auffinden von Text in PDF-Dateien mithilfe von Such-APIs.
- Syncfusion ASP.NET Core PDF (Teil von Syncfusion Essential Studio Enterprise) erleichtert die Textextraktion und Keyword-Suchen in PDFs.
Für eine detaillierte Analyse der Funktionen und des Preises besuchen Sie unseren Vergleich der ASP.NET Core PDF-Komponenten.