Extraction de contenu à partir d’un PDF dans .NET
Rendez les données PDF plus accessibles en automatisant l’extraction de données.
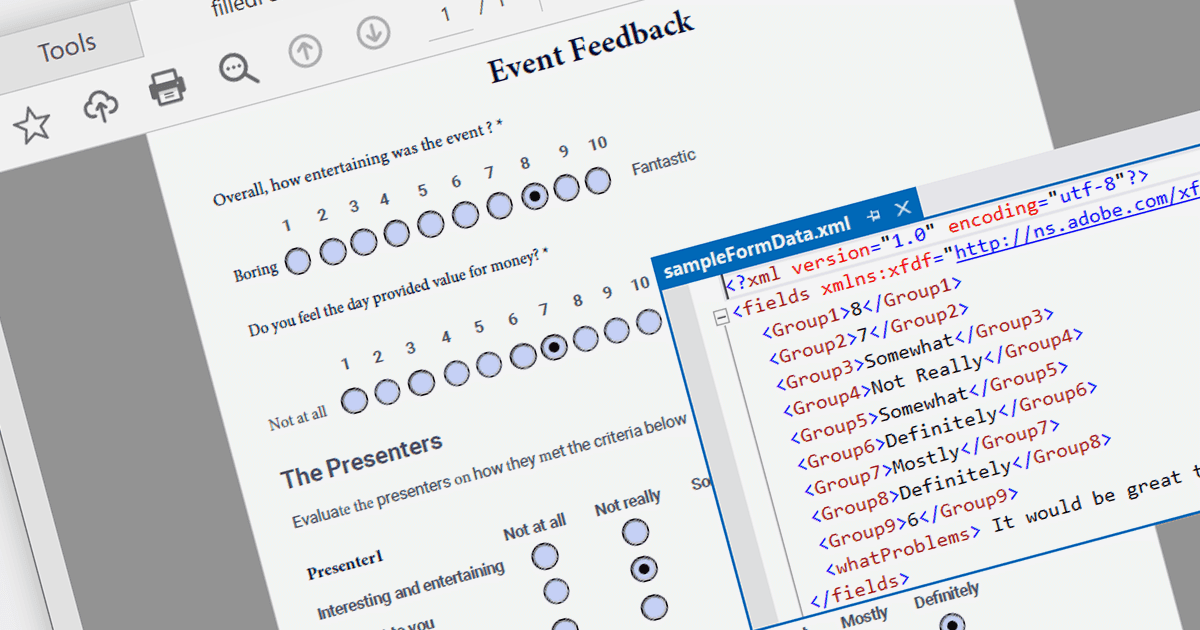
L’extraction de données PDF est le processus consistant à extraire par programmation des informations textuelles et visuelles à partir de documents PDF. Elle permet aux développeurs d’analyser des fichiers, d’extraire du texte, des images et d’autres éléments, en facilitant des tâches telles que l’indexation des documents et le data mining.
Plusieurs composants PDF .NET offrent des fonctionnalités d’extraction de contenu, notamment :
- Aspose.PDF for .NET est une bibliothèque complète qui permet d’extraire facilement du texte, des images et d’autres éléments des fichiers PDF.
- IronPDF for .NET est une suite d’outils PDF polyvalente permettant l’extraction de contenu, la conversion et la manipulation de fichiers PDF dans des applications .NET.
- LEADTOOLS PDF Pro est une boîte à outils avancée qui permet aux développeurs d’extraire du texte et des métadonnées depuis des PDF.
- GrapeCity Documents for PDF est un composant riche en fonctionnalités pour .NET, facilitant l’extraction et la gestion du contenu à partir de fichiers PDF.
- XFINIUM.PDF CROSS PLATFORM EDITION est une bibliothèque PDF multiplateforme pour .NET, offrant des fonctionnalités efficaces d’extraction et de traitement du contenu.
Pour une analyse approfondie des fonctionnalités et des tarifs, consultez notre comparaison des composants PDF .NET.