Optimisez la gestion des PDF avec l’extraction XMP
Améliorez l’efficacité, développez l’automatisation et obtenez des informations en extrayant par programmation les métadonnées XMP depuis des fichiers PDF.
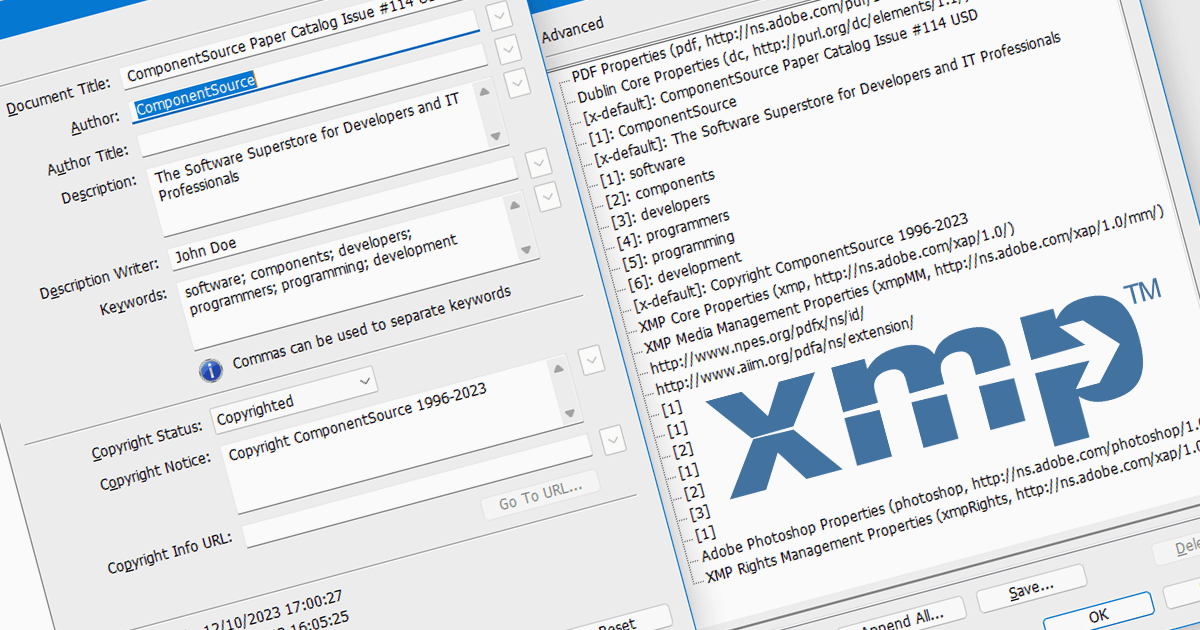
XMP, ou Extensible Metadata Platform, agit comme une étiquette numérique intégrée dans les PDF, contenant des informations allant au-delà du document lui-même. Il renferme des détails tels que les noms des auteurs, les dates de création, les mots-clés et même l’historique des révisions. L’extraction par programmation de ces données XMP ouvre un véritable trésor de possibilités. Imaginez organiser automatiquement les PDF en fonction de l’auteur ou du mot-clé, extraire les informations de copyright à des fins juridiques, ou encore retracer l’évolution d’un document grâce à ses horodatages XMP. Cette puissance rend l’extraction XMP inestimable pour les chercheurs, les bibliothécaires et toute personne souhaitant tirer le maximum de sa collection de PDF.
Plusieurs composants PDF pour .NET Core prennent en charge l’extraction de la métadonnée XMP, notamment :
- Aspose.PDF pour .NET est une bibliothèque avancée pour la manipulation de PDF, incluant des fonctionnalités d’extraction et d’édition des métadonnées XMP, compatible avec .NET Core.
- DevExpress PDF Document API (faisant partie de DevExpress Office File API) inclut une propriété PdfDocument.Metadata qui vous permet d’accéder aux métadonnées d’un document.
- ImageGear pour .NET d’Accusoft est un puissant kit de traitement de documents comprenant des options d’extraction des métadonnées XMP ainsi que l’extraction de texte pour des cas d’usage avec .NET Core.
- Document Solutions for PDF de MESCIUS (anciennement GrapeCity) est une bibliothèque PDF spécialisée permettant un accès et une manipulation fluides des métadonnées XMP dans des environnements .NET Core.
Pour une analyse approfondie des fonctionnalités et des tarifs, consultez notre comparaison des composants PDF pour .NET Core.