Trouver rapidement du contenu dans les documents PDF
Permettez à votre application de localiser et d’extraire un texte spécifique à partir de fichiers PDF, que ce soit pour la navigation, la validation ou l’extraction de données.
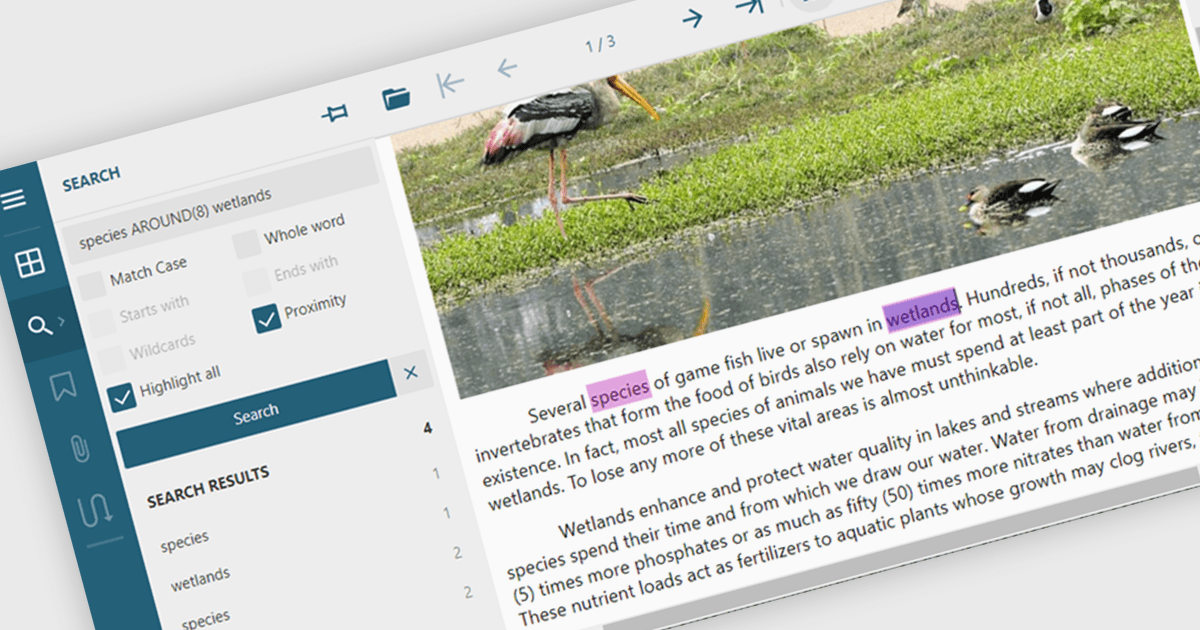
La recherche de texte dans un composant PDF fait référence à la capacité de localiser et d’extraire par programmation du texte dans un document PDF à partir de critères de recherche spécifiques. Cette fonctionnalité prend généralement en charge la distinction entre majuscules et minuscules, la correspondance de mots entiers et les expressions régulières, ce qui permet d’effectuer des requêtes précises sur l’ensemble des pages ou des sections du document. Pour les développeurs, elle facilite la création de fonctionnalités telles que la mise en évidence de mots-clés, l’indexation des documents, la validation du contenu et des workflows automatisés de masquage (redaction). En intégrant la recherche de texte, les applications peuvent interagir efficacement avec le contenu PDF sans révision manuelle, ce qui permet de gagner du temps et d’améliorer l’accessibilité et la précision des données sur l’ensemble des systèmes d’automatisation des documents et de l’entreprise.
Plusieurs composants PDF pour ASP.NET Core vous permettent de rechercher du texte dans un fichier PDF, notamment :
- Document Solutions for PDF de MESCIUS vous permet d’effectuer des recherches de texte en respectant la casse, sur des PDFs, pour une gestion précise du contenu.
- Telerik UI PDF for ASP.NET Core (faisant partie de Telerik UI for ASP.NET Core) vous permet de localiser du texte dans des fichiers PDF grâce à des API de recherche.
- Syncfusion ASP.NET Core PDF (faisant partie de Syncfusion Essential Studio Enterprise) facilite l’extraction de texte et les recherches par mots-clés dans les PDFs.
Pour une analyse approfondie des fonctionnalités et des prix, consultez notre comparaison des composants PDF pour ASP.NET Core.