.NET에서 PDF의 콘텐츠 추출
데이터 추출을 자동화하여 PDF 데이터를 더 쉽게 사용할 수 있도록 하세요.
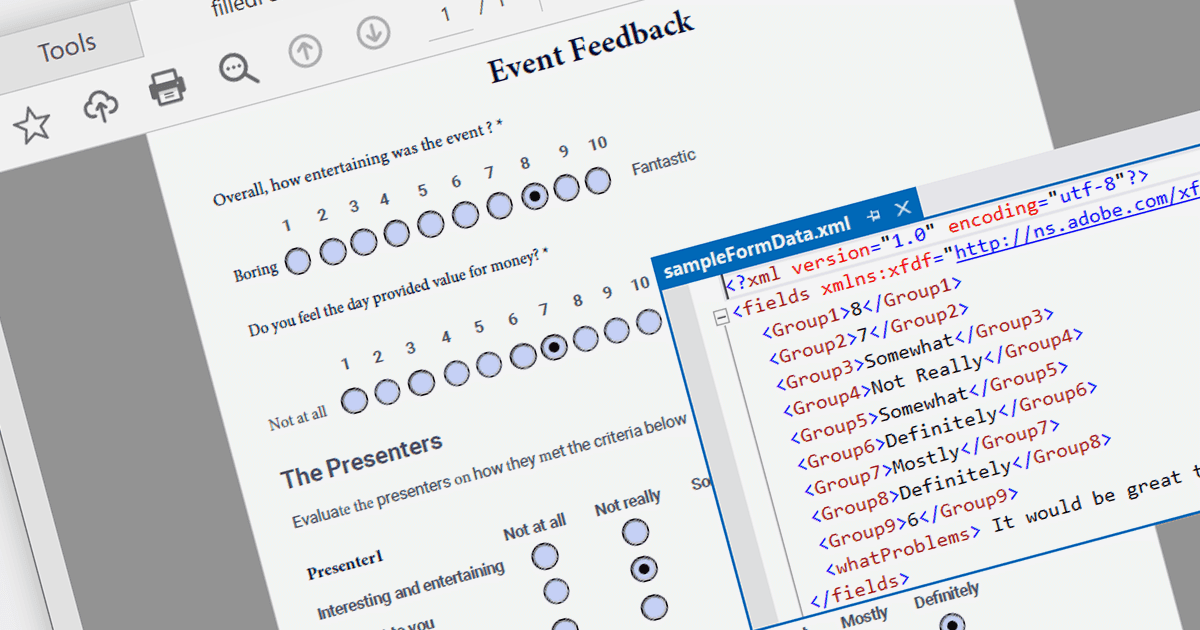
PDF 데이터 추출은 PDF 문서에서 텍스트 및 시각 정보를 프로그래밍 방식으로 추출하는 과정입니다. 이를 통해 개발자는 파일을 파싱하고 텍스트, 이미지 및 기타 요소를 추출하여 문서 인덱싱, 텍스트 마이닝과 같은 작업을 보다 쉽게 수행할 수 있습니다.
여러 .NET PDF 구성 요소에서 콘텐츠 추출 기능을 제공합니다. 예를 들어:
- Aspose.PDF for .NET은 손쉽게 PDF 파일에서 텍스트, 이미지 및 기타 요소를 추출할 수 있도록 해주는 포괄적인 라이브러리입니다.
- IronPDF for .NET은 .NET 애플리케이션에서 PDF 파일의 콘텐츠 추출, 변환 및 처리를 가능하게 하는 다용도 PDF 툴셋입니다.
- LEADTOOLS PDF Pro는 개발자가 PDF에서 텍스트와 메타데이터를 추출할 수 있도록 해주는 고급 툴킷입니다.
- GrapeCity Documents for PDF는 .NET용 기능이 풍부한 구성 요소로, PDF 파일에서 콘텐츠 추출 및 관리를 손쉽게 할 수 있습니다.
- XFINIUM.PDF CROSS PLATFORM EDITION은 .NET용 크로스 플랫폼 PDF 라이브러리로, 효율적인 콘텐츠 추출 및 처리 기능을 제공합니다.
기능과 가격에 대한 자세한 분석을 보려면 .NET PDF 구성 요소 비교를 확인하세요.