XMP 추출로 PDF 관리를 개선하세요
PDF 파일에서 XMP 메타데이터를 프로그래밍 방식으로 추출하여 효율성을 높이고 자동화를 유도하며 인사이트를 얻으세요.
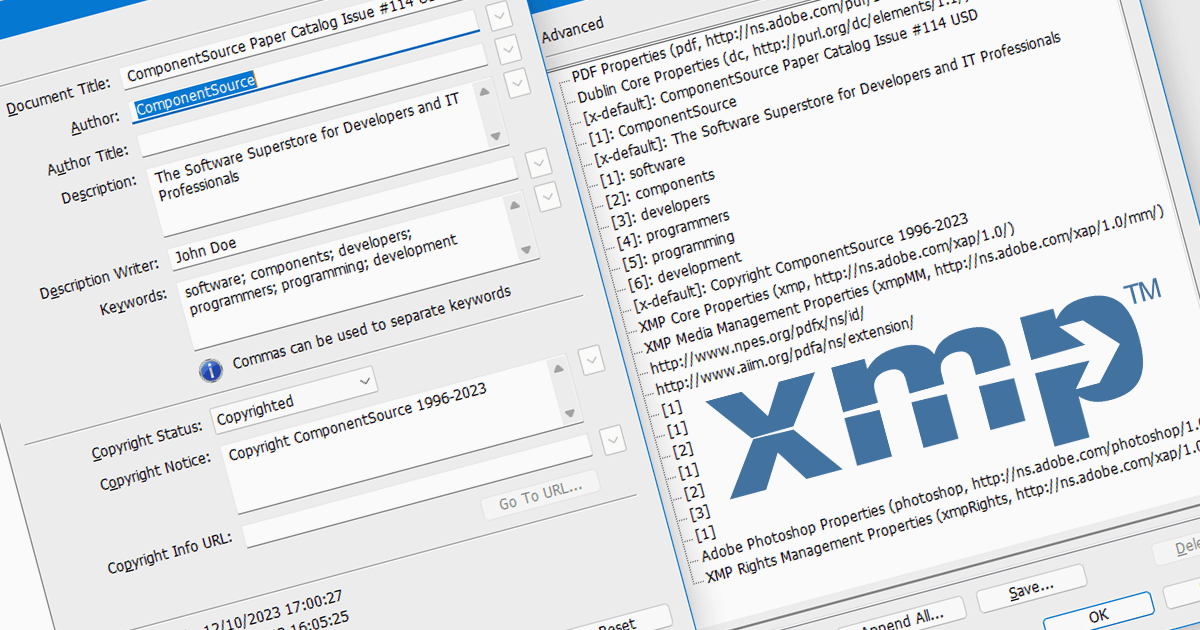
XMP(Extensible Metadata Platform)는 PDF 안에 임베드된 디지털 라벨처럼 동작하며, 문서 자체를 넘어서는 정보를 담고 있습니다. 작성자 이름, 생성 날짜, 키워드, 그리고 수정 이력과 같은 세부 정보를 포함합니다. 프로그래밍 방식으로 이 XMP 데이터를 추출하면 수많은 가능성이 열립니다. 예를 들어 작성자나 키워드를 기준으로 PDF를 자동으로 정리하고, 법적 목적을 위한 저작권 정보를 추출하거나, XMP 타임스탬프를 통해 문서의 변화를 추적할 수도 있습니다. 이러한 XMP 추출의 가치는 연구자, 사서, 그리고 자신의 PDF 컬렉션에서 최대한의 가치를 뽑고 싶은 모든 사람에게 매우 중요합니다.
다음과 같은 여러 .NET Core PDF 구성 요소에서 XMP 메타데이터 추출을 지원합니다:
- Aspose.PDF for .NET은 PDF 조작을 위한 고급 라이브러리로, .NET Core에서 작동하며 XMP 메타데이터 추출 및 편집 기능을 포함합니다.
- DevExpress PDF Document API (DevExpress Office File API의 일부)에는 문서의 메타데이터에 접근할 수 있는 PdfDocument.Metadata 속성이 포함되어 있습니다.
- Accusoft의 ImageGear for .NET은 .NET Core 사용 사례를 위한 텍스트 추출은 물론 XMP 메타데이터 추출 옵션도 제공하는 강력한 문서 처리 툴킷입니다.
- Document Solutions for PDF는 MESCIUS(이전 GrapeCity)가 제공하는 전문 PDF 라이브러리로, .NET Core 환경에서 XMP 메타데이터에 대한 원활한 접근과 조작을 가능하게 합니다.
기능과 가격에 대한 자세한 분석은 .NET Core PDF 구성 요소 비교를 참고하세요.