뷰어를 통해 PDF 콘텐츠 캡처
PDF 문서에서 사용자 선택 텍스트와 영역을 애플리케이션이 직접 추출할 수 있도록 하여, 검색된 데이터가 화면에서 보이는 상호작용과 일치하도록 합니다.
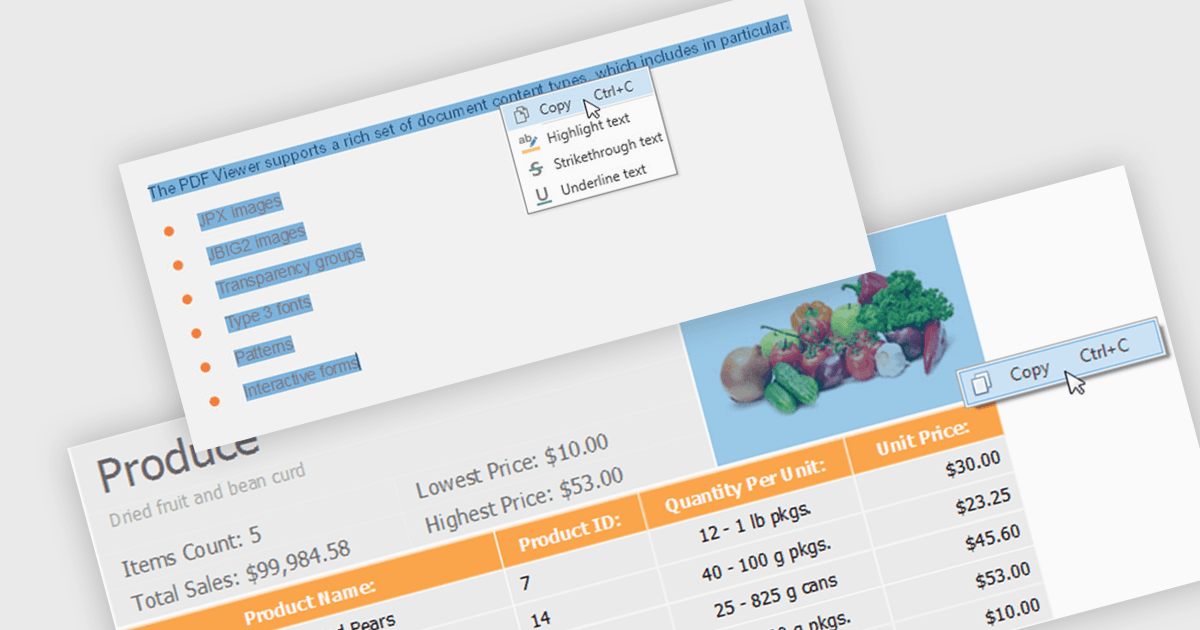
PDF 뷰어를 사용해 콘텐츠를 추출한다는 것은, 텍스트 선택, 영역 선택 또는 페이지 단위 캡처와 같은 대화형 작업을 바탕으로 최종 사용자나 애플리케이션이 뷰어의 사용자 인터페이스를 통해 직접 콘텐츠를 선택하고 검색할 수 있도록 하는 것을 의미합니다. 소프트웨어 개발자 관점에서 이는 뷰어가 단순한 렌더링 표면일 뿐만 아니라, 선택한 텍스트·이미지·영역을 노출하는 제어된 추출 계층 역할을 한다는 뜻입니다. 이 방식은 검토, 승인 및 데이터 캡처 시나리오에서 유용한데, 사용자 의도가 명확하게 반영되고 화면에서 사용자가 실제로 선택한 항목과 추출 데이터가 일치하며, 백그라운드 파싱에만 의존하지 않기 때문에 애플리케이션 내에서 보다 예측 가능하고 사용자 주도적인 콘텐츠 검색이 가능해지기 때문입니다.
여러 WinForms PDF Viewer 구성 요소는 콘텐츠 추출을 지원하며, 예를 들어:
- DevExpress WinForms PDF Viewer (DevExpress WinForms의 일부)에서는 PDF 뷰어를 통해 사용자가 선택한 텍스트와 시각적 영역을 직접 추출할 수 있습니다.
- Telerik UI for WinForms PDF Viewer (Telerik UI for WinForms의 일부)에서는 뷰어에서 시각적으로 선택한 PDF 콘텐츠를 캡처하여, 사용자 상호작용에 맞춰 정렬된 텍스트를 반환합니다.
- PDFView4NET Windows Forms Edition (PDF4DEV Solutions)에서는 사용자가 선택한 내용을 기반으로 PDF 뷰어에서 텍스트, 이미지 및 영역을 추출하는 데 도움이 됩니다.
- Syncfusion WinForms PDF Viewer (Syncfusion Essential Studio Enterprise의 일부)에서는 뷰어를 통해 사용자가 선택한 PDF 텍스트와 영역을 검색할 수 있습니다.
기능과 가격에 대한 자세한 분석은 WinForms PDF Viewer 구성 요소 비교를 참조하세요.