Melhore o gerenciamento de PDFs com a extração de XMP
Aumente a eficiência, impulsione a automação e obtenha insights extraindo programaticamente os metadados XMP de arquivos PDF.
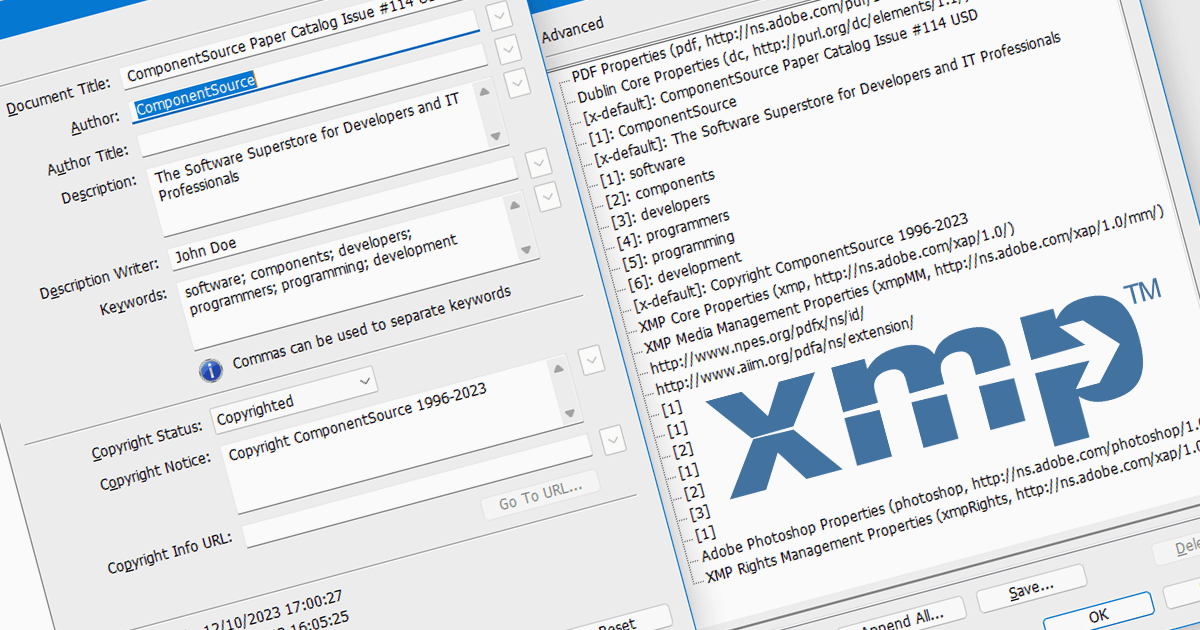
XMP, ou Extensible Metadata Platform, atua como uma etiqueta digital incorporada em PDFs, carregando informações além do próprio documento. Ela mantém detalhes como nomes de autor, datas de criação, palavras-chave e até mesmo o histórico de revisões. A extração programática desses dados XMP desbloqueia um verdadeiro leque de possibilidades. Imagine organizar automaticamente PDFs com base no autor ou na palavra-chave, extrair informações de direitos autorais para fins legais ou até mesmo rastrear a evolução de um documento por meio de seus carimbos de data/hora no XMP. Esse poder torna a extração de XMP indispensável para pesquisadores, bibliotecários e para qualquer pessoa que queira aproveitar ao máximo sua coleção de PDFs.
Vários componentes de PDF para .NET Core oferecem suporte à extração de metadados XMP, incluindo:
- Aspose.PDF for .NET é uma biblioteca avançada para manipulação de PDFs, incluindo recursos de extração e edição de metadados XMP, que funciona com .NET Core.
- DevExpress PDF Document API (parte da DevExpress Office File API) inclui uma propriedade PdfDocument.Metadata que permite acessar os metadados de um documento.
- ImageGear for .NET da Accusoft é um poderoso kit de ferramentas de processamento de documentos que apresenta opções de extração de metadados XMP, além de extração de texto para casos de uso com .NET Core.
- Document Solutions for PDF da MESCIUS (anteriormente GrapeCity) é uma biblioteca especializada em PDFs que permite acesso e manipulação de metadados XMP de forma perfeita em ambientes .NET Core.
Para uma análise aprofundada de recursos e preço, visite nossa comparação de Componentes de PDF para .NET Core.