Encontre conteúdo rapidamente em documentos PDF
Permita que seu aplicativo localize e extraia um texto específico de arquivos PDF, seja para navegação, validação ou extração de dados.
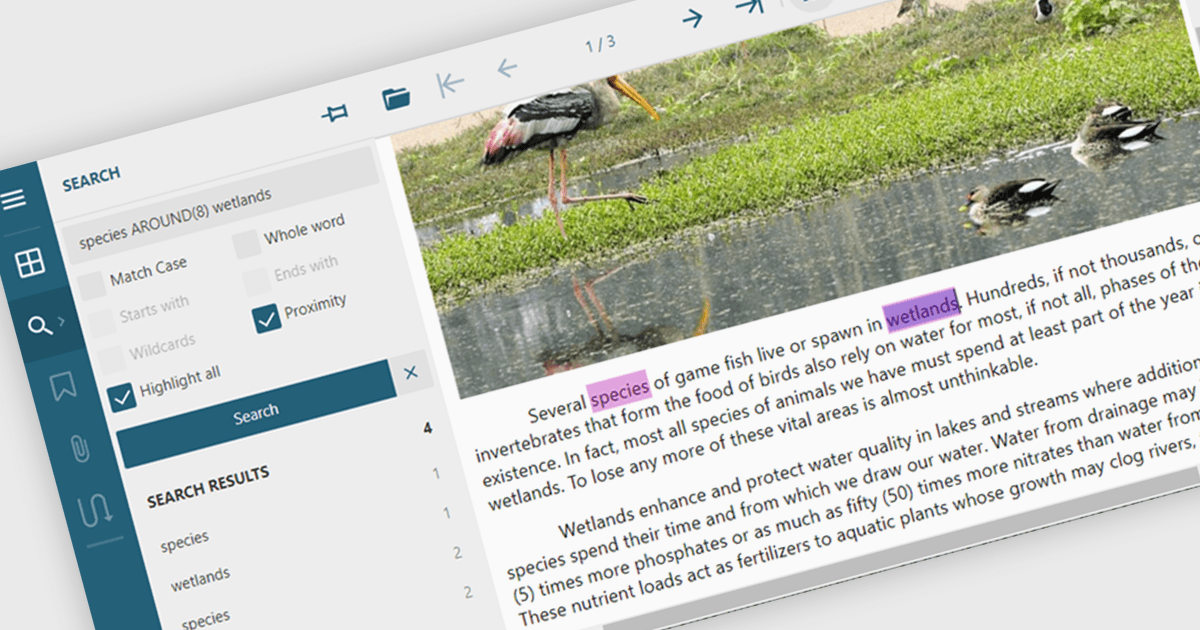
Busca de texto em um componente de PDF refere-se à capacidade de localizar e extrair programaticamente texto dentro de um documento PDF com base em critérios de pesquisa específicos. Essa funcionalidade normalmente oferece suporte a sensibilidade a maiúsculas e minúsculas, correspondência de palavra inteira e expressões regulares, permitindo consultas precisas em páginas ou seções do documento. Para desenvolvedores, ela facilita a criação de recursos como realce de palavras-chave, indexação de documentos, validação de conteúdo e fluxos de trabalho automatizados de redação. Ao integrar a busca de texto, as aplicações podem interagir de forma eficiente com o conteúdo de PDFs sem revisão manual, economizando tempo e melhorando a acessibilidade e a precisão dos dados em sistemas de automação de negócios e documentos.
Diversos componentes de PDF do ASP.NET Core permitem que você pesquise por texto dentro de um arquivo PDF, incluindo:
- Document Solutions for PDF da MESCIUS permite realizar pesquisas de texto com sensibilidade a maiúsculas e minúsculas em PDFs para um manuseio preciso do conteúdo.
- Telerik UI PDF for ASP.NET Core (parte do Telerik UI for ASP.NET Core) permite localizar texto em arquivos PDF usando APIs de pesquisa.
- Syncfusion ASP.NET Core PDF (parte do Syncfusion Essential Studio Enterprise) facilita a extração de texto e pesquisas por palavras-chave em PDFs.
Para uma análise aprofundada de recursos e preço, visite nossa comparação de componentes de PDF do ASP.NET Core.