Mejore la gestión de PDF con la extracción de XMP
Mejora la eficiencia, impulsa la automatización y adquiere información valiosa extrayendo metadatos XMP de forma programática desde archivos PDF.
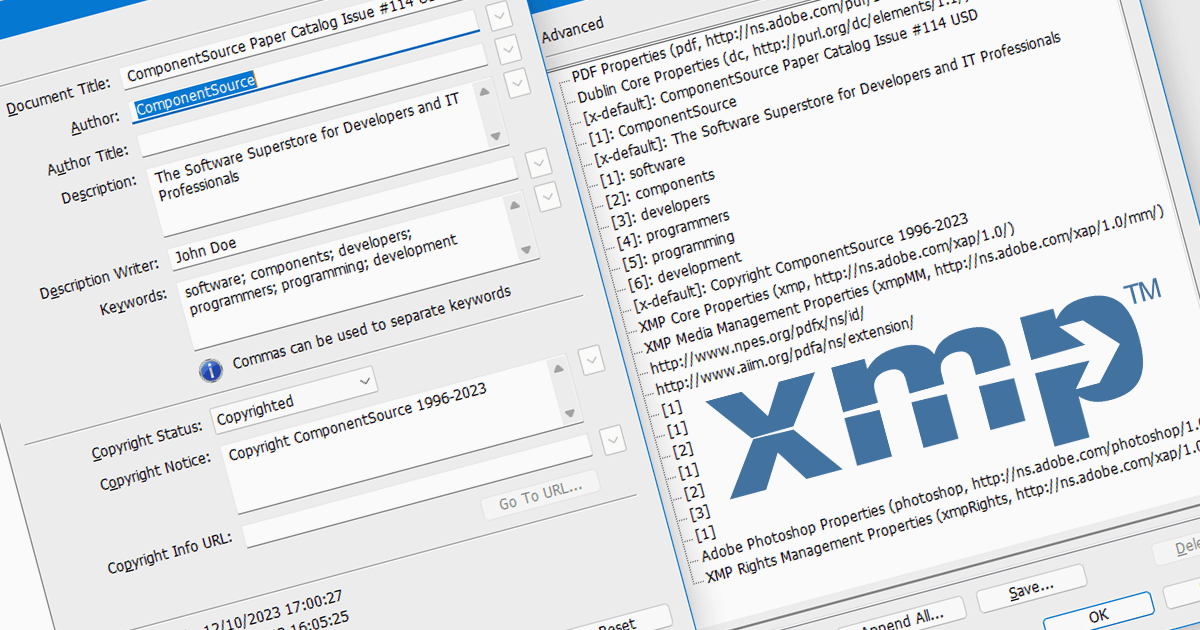
XMP, o Plataforma de Metadatos Extensibles (Extensible Metadata Platform), actúa como una etiqueta digital integrada en los PDF, con información que va más allá del propio documento. Contiene detalles como los nombres de los autores, las fechas de creación, las palabras clave e incluso el historial de revisiones. Extraer este dato XMP de forma programática desbloquea un sinfín de posibilidades. Imagina organizar automáticamente los PDF en función del autor o la palabra clave, extraer información de copyright con fines legales o incluso rastrear la evolución de un documento a través de sus marcas de tiempo XMP. Esta capacidad hace que la extracción de XMP sea imprescindible para investigadores, bibliotecarios y para cualquiera que quiera aprovechar al máximo su colección de PDF.
Varios componentes de PDF de .NET Core admiten la extracción de metadatos XMP, incluyendo:
- Aspose.PDF para .NET es una biblioteca avanzada para la manipulación de PDF, incluidas funciones de extracción y edición de metadatos XMP, que funciona con .NET Core.
- DevExpress PDF Document API (parte de DevExpress Office File API) incluye la propiedad PdfDocument.Metadata, que le permite acceder a los metadatos de un documento.
- ImageGear para .NET de Accusoft es un potente conjunto de herramientas de procesamiento de documentos que ofrece opciones para la extracción de metadatos XMP, además de extracción de texto para casos de uso con .NET Core.
- Document Solutions for PDF de MESCIUS (anteriormente GrapeCity) es una biblioteca de PDF especializada que permite un acceso y una manipulación de metadatos XMP fluidos en entornos .NET Core.
Para un análisis en profundidad de las funciones y el precio, visite nuestra comparación de Componentes de PDF de .NET Core.