Encuentre contenido rápidamente en documentos PDF
Permita que su aplicación localice y extraiga texto específico de archivos PDF, ya sea para navegación, validación o extracción de datos.
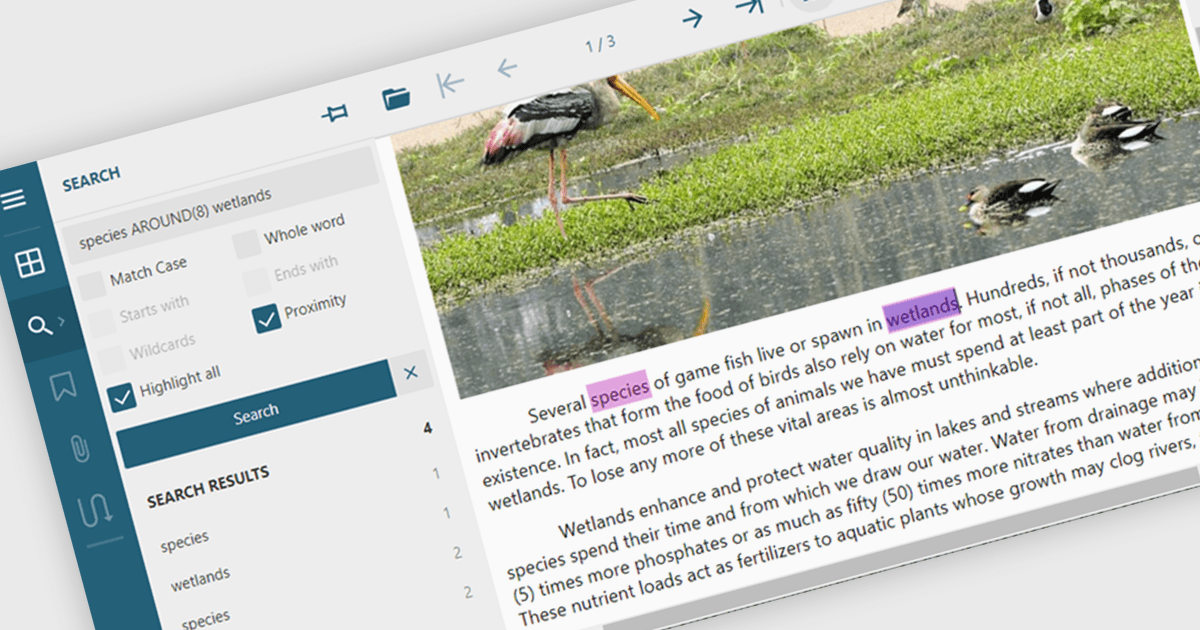
La búsqueda de texto en un componente PDF se refiere a la capacidad de localizar y extraer texto de forma programática dentro de un documento PDF según criterios de búsqueda específicos. Esta funcionalidad normalmente admite sensibilidad a mayúsculas y minúsculas, coincidencia de palabras completas y expresiones regulares, lo que permite realizar consultas precisas en páginas o secciones del documento. Para los desarrolladores, facilita la creación de funciones como el resaltado de palabras clave, la indexación de documentos, la validación de contenido y los flujos de trabajo de redacción automatizada. Al integrar la búsqueda de texto, las aplicaciones pueden interactuar de forma eficiente con el contenido de PDF sin revisión manual, ahorrando tiempo y mejorando la accesibilidad y la precisión de los datos en los sistemas de automatización empresarial y de documentos.
Varios componentes de PDF de ASP.NET Core le permiten buscar texto dentro de un archivo PDF, incluyendo:
- Document Solutions for PDF de MESCIUS le permite realizar búsquedas de texto con distinción entre mayúsculas y minúsculas en PDFs para un manejo preciso del contenido.
- Telerik UI PDF for ASP.NET Core (parte de Telerik UI for ASP.NET Core) le permite localizar texto dentro de archivos PDF mediante API de búsqueda.
- Syncfusion ASP.NET Core PDF (parte de Syncfusion Essential Studio Enterprise) facilita la extracción de texto y las búsquedas de palabras clave en PDFs.
Para un análisis en profundidad de las funciones y el precio, visite nuestra comparación de componentes PDF de ASP.NET Core.