Migliora la gestione dei PDF con l’estrazione XMP
Migliora l’efficienza, favorisci l’automazione e ottieni informazioni preziose estraendo in modo programmatico i metadati XMP dai file PDF.
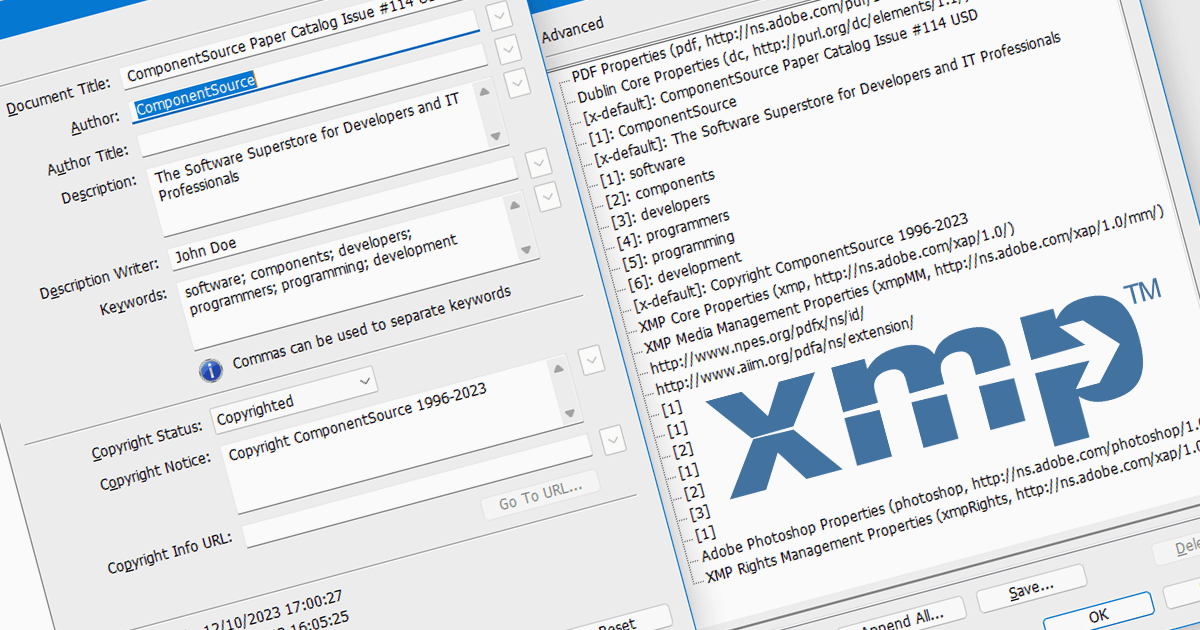
XMP, o Extensible Metadata Platform, funge da etichetta digitale incorporata nei PDF, contenente informazioni che vanno oltre il documento stesso. Include dettagli come i nomi degli autori, le date di creazione, le parole chiave e persino la cronologia di revisione. L’estrazione programmatica di questi dati XMP sblocca un mondo di possibilità. Immagina di organizzare automaticamente i PDF in base all’autore o alla parola chiave, di estrarre le informazioni sul copyright a fini legali o persino di tracciare l’evoluzione di un documento attraverso i timestamp XMP. Questa potenza rende l’estrazione XMP fondamentale per ricercatori, bibliotecari e per chiunque voglia ottenere il massimo dalla propria collezione di PDF.
Diversi componenti PDF per .NET Core supportano l’estrazione dei metadati XMP, inclusi:
- Aspose.PDF for .NET è una libreria avanzata per la manipolazione dei PDF, con funzionalità di estrazione e modifica dei metadati XMP, che funziona con .NET Core.
- DevExpress PDF Document API (parte di DevExpress Office File API) include una proprietà PdfDocument.Metadata che consente di accedere ai metadati di un documento.
- ImageGear for .NET di Accusoft è un potente toolkit di elaborazione documenti che offre opzioni per l’estrazione dei metadati XMP e anche l’estrazione del testo per scenari con .NET Core.
- Document Solutions for PDF di MESCIUS (precedentemente GrapeCity) è una libreria PDF specializzata che abilita l’accesso e la manipolazione dei metadati XMP in modo fluido negli ambienti .NET Core.
Per un’analisi approfondita di funzionalità e prezzi, visita il nostro confronto tra componenti PDF per .NET Core.