在 .NET 中从 PDF 提取内容
通过自动化数据提取,让 PDF 数据更易于访问。
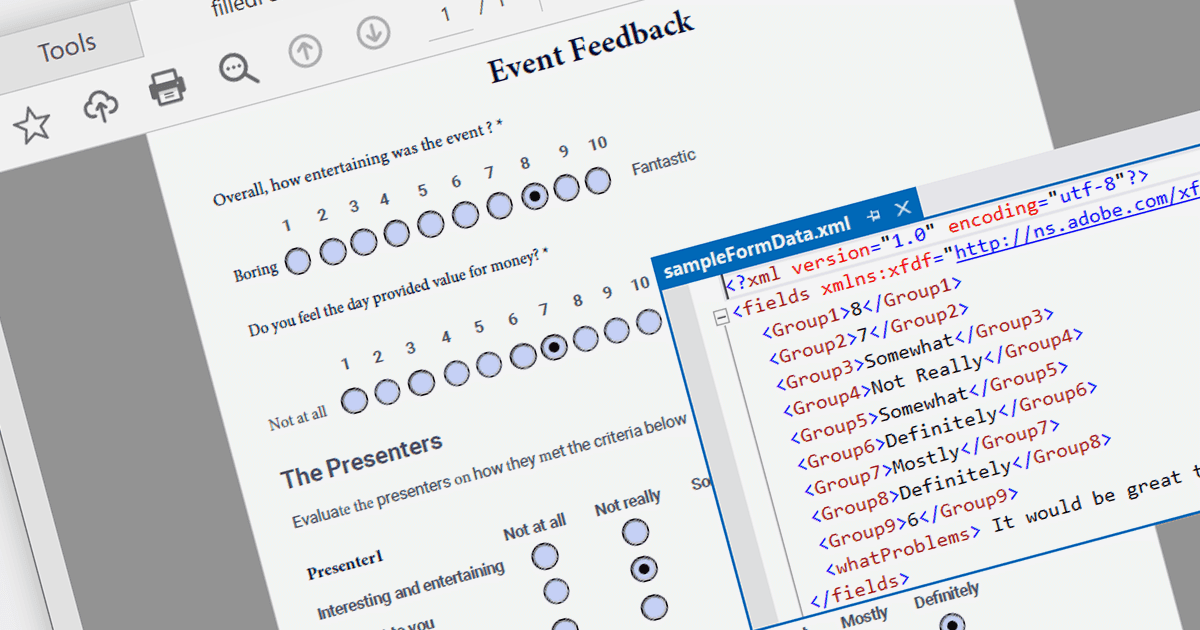
PDF 数据提取是指通过编程方式从 PDF 文档中提取文本和视觉信息的过程。它使开发者能够解析文件、提取文本、图像以及其他元素,从而便于文档编索引、文本挖掘等任务。
一些 .NET PDF 组件提供内容提取功能,包括:
- Aspose.PDF for .NET 是一个功能全面的库,可让您轻松地从 PDF 文件中提取文本、图像及其他元素。
- IronPDF for .NET 是一个灵活的 PDF 工具集,可在 .NET 应用中为 PDF 文件提供内容提取、转换和处理等能力。
- LEADTOOLS PDF Pro 是一款先进的工具包,允许开发者从 PDF 中提取文本和元数据。
- GrapeCity Documents for PDF 是一个面向 .NET 的功能丰富组件,便于对 PDF 文件中的内容进行提取和管理。
- XFINIUM.PDF CROSS PLATFORM EDITION 是适用于 .NET 的跨平台 PDF 库,提供高效的内容提取与处理功能。
如需深入了解功能和价格,请访问我们的 .NET PDF 组件对比。