借助 XMP 提取改进 PDF 管理
通过以编程方式从 PDF 文件中提取 XMP 元数据,提高效率、推动自动化,并获得洞察。
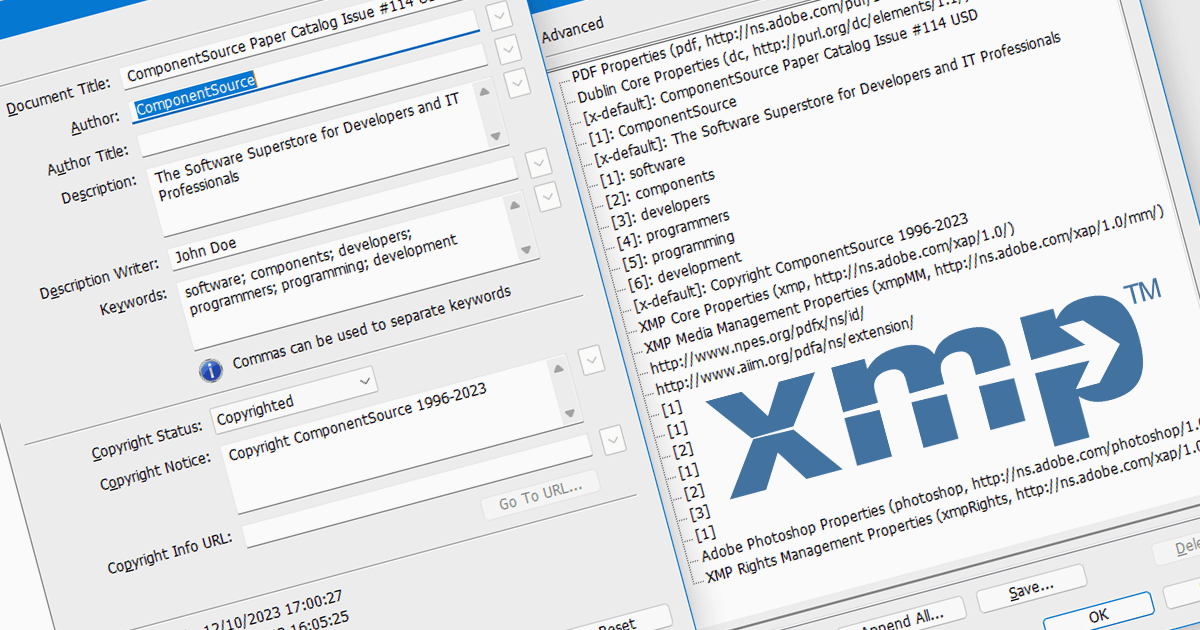
XMP 或可扩展元数据平台,类似于嵌入在 PDF 中的数字标签,能够携带文档本身之外的信息。它包含作者姓名、创建日期、关键词,甚至还有修订历史等细节。以编程方式提取这些 XMP 数据,可以解锁无数可能性。想象一下,能够根据作者或关键词自动整理 PDF;为法律用途提取版权信息;甚至通过 XMP 时间戳追踪文档的演变过程。正因如此,XMP 提取对于研究人员、图书馆员以及任何希望充分利用其 PDF 资料库的人来说都非常宝贵。
多种 .NET Core PDF 组件支持提取 XMP 元数据,包括:
- Aspose.PDF for .NET 是一个用于 PDF 操作的高级库,包含 XMP 元数据提取与编辑功能,适用于 .NET Core。
- DevExpress PDF Document API(属于 DevExpress Office File API)包含一个 PdfDocument.Metadata 属性,使您能够访问文档的元数据。
- ImageGear for .NET 是 Accusoft 提供的一个强大的文档处理工具包,提供 XMP 元数据提取选项,以及用于 .NET Core 场景的文本提取功能。
- Document Solutions for PDF 是 MESCIUS(此前为 GrapeCity)提供的一款专用 PDF 库,可在 .NET Core 环境中实现 XMP 元数据的无缝访问与操作。
如需更深入了解功能与价格,请访问我们的 .NET Core PDF 组件对比。